


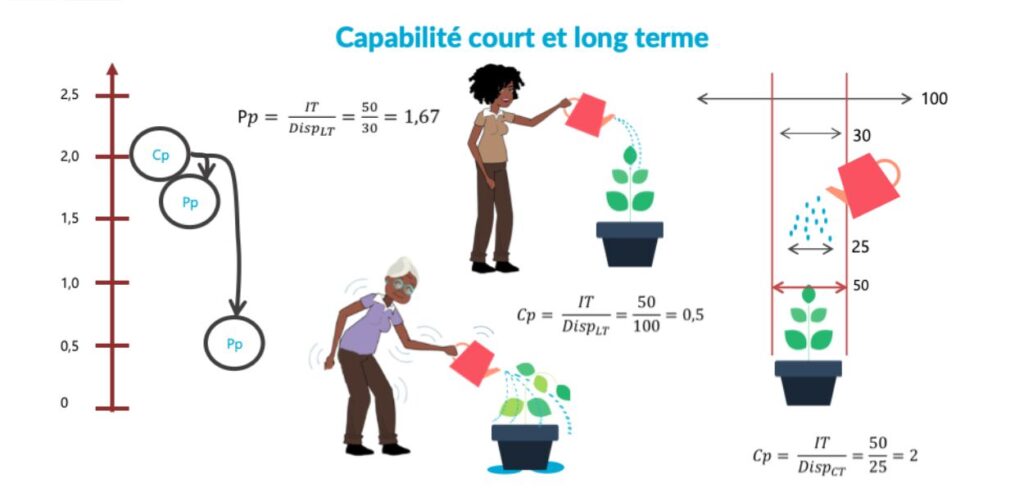
Cp et Pp : deux indices de capabilité à ne pas confondre
Les indices de capabilité permettent de quantifier l’aptitude d’un procédé à produire des pièces conformes aux spécifications. Parmi eux, Cp et Pp sont souvent présentés côte à côte dans les rapports qualité, au point d’être parfois utilisés de façon interchangeable. C’est une erreur. Ces deux indices reposent sur des hypothèses fondamentalement différentes, et les confondre peut conduire à des décisions erronées sur la maîtrise d’un procédé.
Ce que mesurent Cp et Pp
Les deux indices comparent l’étendue de la tolérance — c’est-à-dire l’écart entre la limite supérieure de spécification (LSS) et la limite inférieure de spécification (LIS) — à la dispersion du procédé. La formule de base est identique :
$$Cp = \frac{LSS – LIS}{6\sigma} \qquad Pp = \frac{LSS – LIS}{6s}$$
À première vue, les formules se ressemblent. La différence se cache dans le dénominateur : Cp utilise σ (sigma estimé), tandis que Pp utilise s (l’écart-type total calculé sur l’ensemble de l’échantillon).
Un indice supérieur à 1,33 est généralement considéré comme satisfaisant dans l’industrie. En dessous de 1,00, le procédé produit des non-conformités.
La différence clé : estimation de la variabilité
C’est ici que tout se joue. L’écart-type utilisé au dénominateur ne provient pas de la même source.
Pour Cp, σ est estimé à partir de la variabilité in the short term, mesurée à l’intérieur des sous-groupes (par exemple, via l’étendue moyenne R̄ ou l’écart-type moyen S̄ des sous-groupes sur une carte de contrôle). Cette estimation ne capture que la variation inhérente au procédé lorsqu’il est en état de maîtrise statistique — ce qu’on appelle la variabilité naturelle or bruit de fond.
Pour Pp, s est l’écart-type global, calculé directement sur l’ensemble des mesures individuelles, sans tenir compte de la structure temporelle des données. Il intègre toutes les sources de variation : la variabilité à court terme, mais aussi les dérives, les décalages entre équipes, les changements de matière première, bref, tout ce qui s’est produit pendant la période d’étude.
En pratique, Pp est donc presque toujours inférieur ou égal à Cp, car il prend en compte davantage de variabilité.
Quand utiliser l’un ou l’autre ?
Le choix entre Cp et Pp dépend de ce que vous souhaitez évaluer.
Cp est l’indice du potentiel du procédé. Il répond à la question : si mon procédé était parfaitement centré et statistiquement maîtrisé, serait-il intrinsèquement capable de respecter les tolérances ? C’est un outil de diagnostic utilisé en phase de mise au point ou lors d’une étude de capabilité à court terme (typiquement menée sur 25 à 30 sous-groupes en conditions stables).
Pp est l’indice de performance réelle du procédé. Il répond à la question : sur une longue période de production, dans les conditions réelles, mon procédé produit-il effectivement des pièces conformes ? Il est particulièrement pertinent lors des études de capabilité à long terme ou pour l’analyse de lots de production déjà réalisés.
Un écart trop grand entre Cp et Pp : un signal d’alarme
Si Cp est élevé mais Pp significativement plus bas, cela indique que le procédé a le potential d’être capable, mais que des causes spéciales de variation (dérives, réglages successifs, facteurs environnementaux) dégradent sa performance réelle. Cet écart est un signal clair pour lancer une investigation et stabiliser le procédé avant de conclure à sa capabilité.
À l’inverse, si Cp et Pp sont proches, la variabilité à court terme représente l’essentiel de la variabilité totale : le procédé est relativement stable.
Les limites à garder en tête
Cp et Pp ne renseignent pas sur le centrage du procédé par rapport à la cible. C’est le rôle de leurs homologues Cpk et Ppk, qui intègrent un décalage éventuel entre la moyenne du procédé et le centre de la tolérance. Un procédé peut afficher un Cp de 1,5 et un Cpk de 0,8 s’il est fortement décentré.
Par ailleurs, ces indices supposent que les données suivent une distribution normale. Avant tout calcul de capabilité, il est indispensable de vérifier cette hypothèse — par un test de normalité ou une représentation graphique (histogramme, droite de Henry). Des données non-normales exigent des approches spécifiques : transformation des données, indices non paramétriques ou modélisation par une autre loi de distribution.
Cp et Pp ne sont pas redondants : ils éclairent deux facettes complémentaires de la performance d’un procédé. Utiliser uniquement l’un ou l’autre revient à ne voir qu’une partie de la réalité. Une bonne analyse de capabilité les présente tous les deux, les compare et tire des conclusions sur la stabilité and le potentiel intrinsèque du procédé.