


À quoi elle sert ?
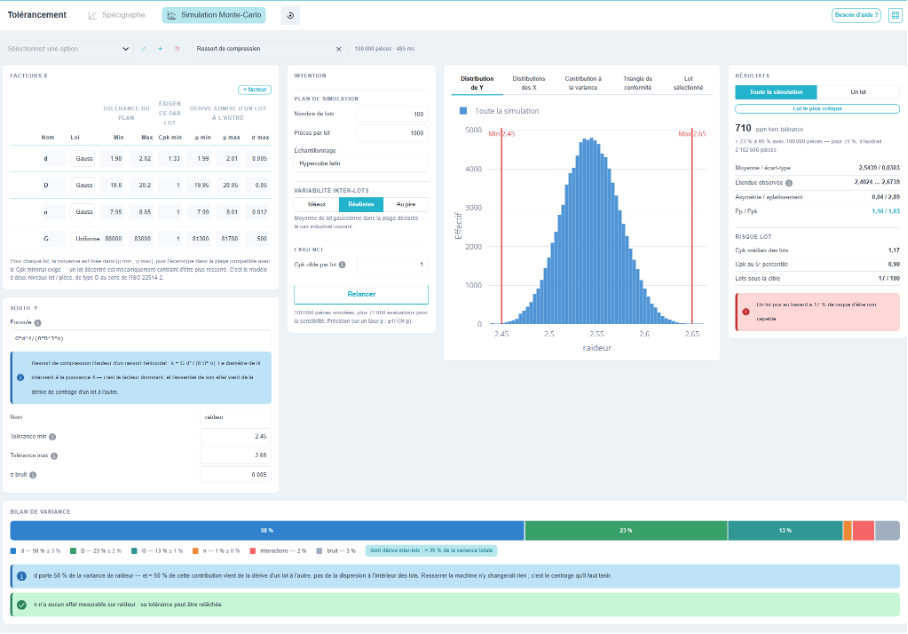
Ici, la relation entre les caractéristiques est connue : c’est une formule. Le calcul d’une raideur de ressort, un jeu d’assemblage, un rapport de transmission. Chaque facteur X a une tolérance de plan, une loi de distribution et une exigence de capabilité. La question est : quelle distribution de Y cela produit-il, quel taux de non-conformité, et quel facteur est responsable de quoi ?
La réponse est obtenue par tirage : des centaines de milliers de pièces virtuelles sont fabriquées, puis mesurées. L’écran travaille dans le sens X → Y uniquement.
Le modèle à deux niveaux : lot puis pièce
C’est le point qui distingue cette simulation de toutes les autres, et il faut le comprendre avant de lire un résultat.
Les logiciels de tolérancement tirent les pièces dans une loi unique, centrée sur la cible, avec la dispersion maximale admise. C’est l’hypothèse du fournisseur parfait : sa moyenne ne dérive jamais. La réalité industrielle est autre la moyenne d’un lot n’est pas celle du lot suivant : changement d’outil, de matière, de machine, de saison.
Ellistat simule donc à deux niveaux. Pour chaque lot, on tire d’abord un réglage une moyenne et un écart-type par facteur puis on tire les pièces de ce lot autour de ce réglage. C’est le modèle de type D de l’ISO 22514-2 (position variable et dispersion variable), et c’est ce qui permet de répondre à la question qui compte vraiment : non pas « une pièce est-elle conforme ? » mais « un lot pris au hasard sera-t-il capable ? ».
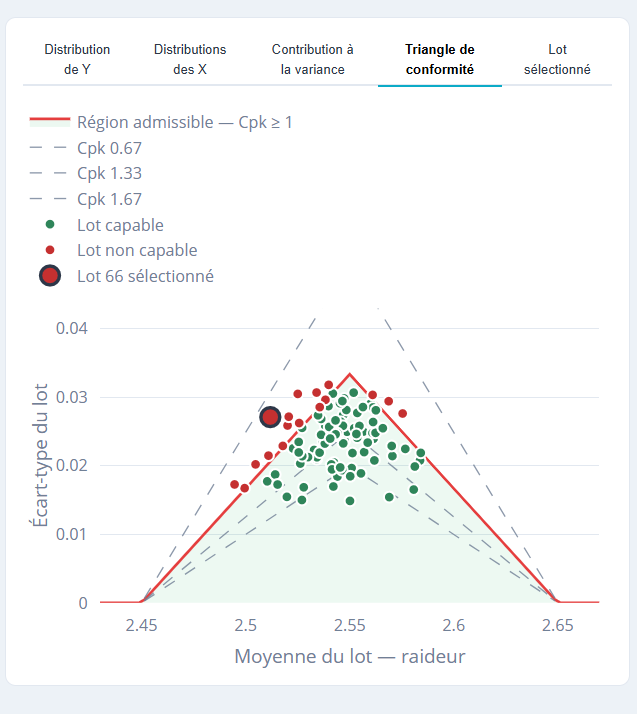
⚠️ Le tirage du réglage de lot n’est pas libre : un lot décentré est mécaniquement contraint d’être plus resserré, car il doit tout de même respecter le Cpk minimal exigé du facteur. Ce couplage n’est pas un artefact de calcul, c’est le comportement d’un fournisseur qui pilote sa capabilité — et il est directement visible sur le triangle de conformité.
Déclarer les facteurs X
Le tableau de la première colonne se remplit ligne par ligne, un facteur par ligne, avec le bouton + facteur. Les colonnes se lisent en trois groupes :
⇒ l’identité du facteur : son nom — celui que vous utiliserez dans la formule — et sa loi (Gauss, Uniforme, Triangulaire, Lognormale) ;
- la tolérance du plan : Min et Max, c’est-à-dire ce qui est écrit sur le dessin ;
- l’exigence par lot : le Cpk minimal que le fournisseur s’engage à tenir sur ce facteur ;
- la dérive admise d’un lot à l’autre : la plage dans laquelle la moyenne du lot peut se promener (μ min, μ max) et l’écart-type maximal σ max.
💡 Les lois ne sont pas paramétrées par leurs paramètres naturels mais par (moyenne, écart-type). C’est ce qui permet de piloter n’importe quelle loi par une exigence de Cpk, et de comparer les lois entre elles à capabilité égale.
La sortie Y et sa formule
Sous le tableau des facteurs, le bloc Sortie Y reçoit la formule, le nom de la grandeur calculée, sa tolérance (Min et Max) et, si nécessaire, un écart-type de bruit tout ce que la formule n’explique pas : phénomènes non modélisés, incertitude de mesure sur Y.
La formule s’écrit en clair, avec les noms des facteurs. Les opérateurs usuels sont acceptés, y compris ^ pour la puissance, ainsi que les fonctions sqrt, abs, exp, log, log10, sin, cos, tan, atan, min, max, pow et la constante PI. Une erreur de saisie est signalée à l’endroit exact où elle se trouve, avec le nom inconnu en cause.
⚠️ Si des tirages produisent une valeur non définie (division par zéro, racine d’un nombre négatif) leur nombre est affiché. Ce n’est pas un détail : cela signifie que votre formule n’est pas valable sur toute la plage de tolérance de vos facteurs.
Le plan de simulation
La colonne Intention règle la façon de simuler : le nombre de lots, le nombre de pièces par lot, la méthode d’échantillonnage, le mode de variabilité inter-lots et le Cpk cible par lot, celui en dessous duquel un lot sera déclaré non capable.
Les trois modes de variabilité inter-lots répondent à trois questions différentes :
| Mode | Comment se comporte la moyenne du lot | Ce qu’il vous dit |
| Idéaux | Chaque lot est parfaitement centré sur la cible. | Le cas optimiste. C’est l’hypothèse que retiennent les logiciels de tolérancement classiques : utile pour comparer, pas pour décider. |
| Réalistes | La moyenne du lot varie autour du centre de la plage admise, les fortes dérives étant plus rares que les petites. | Le cas industriel courant, retenu par défaut. |
| Au pire | La moyenne du lot peut se trouver n’importe où dans la plage admise, sans préférence. | Le cas défavorable : ce qui se passe si le fournisseur exploite toute la dérive que vous lui avez concédée. |
⚠️ Le mode retenu change les résultats du tout au tout : passer de « idéaux » à « au pire » peut multiplier le taux de non-conformité par plusieurs ordres de grandeur, sans qu’aucune tolérance n’ait été modifiée. C’est la dérive de réglage, et non la dispersion machine, qui domine la plupart des cas réels.
L’échantillonnage propose l’hypercube latin, retenu par défaut, ou le Monte-Carlo simple. L’hypercube latin répartit les tirages plus régulièrement dans le domaine et donne, à nombre de pièces égal, un résultat nettement plus stable — d’autant plus que la formule est proche d’une somme, ce qui est le cas de toutes les chaînes de cotes.
Le calcul est lancé par le bouton Simuler. Toute modification d’un paramètre rend le résultat affiché périmé et le bouton repasse en surbrillance : ce que vous lisez correspond toujours au dernier calcul lancé, jamais à la saisie en cours. Le temps de calcul et le nombre de pièces simulées sont affichés en barre de titre.
Les cinq graphiques
Distribution de Y. L’histogramme de la caractéristique de sortie, avec ses limites de spécification. En portée « un lot », l’histogramme du lot sélectionné se superpose à celui de la population entière estompée : on voit d’un coup où ce lot se situe dans l’ensemble.
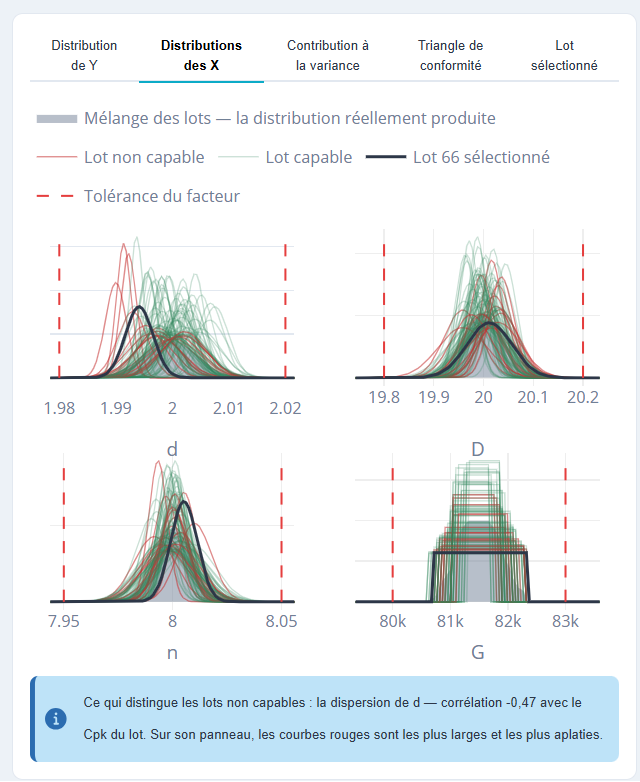
Distributions des X. Un panneau par facteur, et dans chaque panneau une courbe par lot, tracée d’après le réglage tiré pour ce lot. Les courbes sont colorées selon la capabilité du lot sur Y : on voit donc immédiatement ce que les lots ratés ont en commun sur ce facteur (une position décalée, ou une dispersion plus large). Un aplat gris en fond donne le mélange de tous les lots, c’est-à-dire la distribution réellement produite, souvent bien plus large que n’importe quel lot pris isolément. Le lot sélectionné est tracé par-dessus en trait épais, les tolérances du facteur en pointillé.
Sous le graphique, une phrase de diagnostic désigne ce qui distingue les lots non capables : le décentrage d’un facteur, ou sa dispersion, avec la corrélation correspondante.
Contribution à la variance. Des barres horizontales triées, une par facteur, qui répondent à la question « si je devais resserrer une seule tolérance, laquelle ? ». Chaque barre est scindée en deux teintes : la part due à la dispersion à l’intérieur des lots et la part due à la dérive d’un lot à l’autre. Une moustache donne l’intervalle de confiance de l’indice, et deux barres supplémentaires isolent les interactions et le bruit.
💡 C’est la distinction la plus utile de l’écran. Si la contribution d’un facteur vient surtout de la dérive inter-lots, resserrer la machine n’y changera rien : c’est le centrage qu’il faut tenir. Si elle vient de la dispersion intra-lot, c’est le moyen de production qu’il faut améliorer. Les deux leviers n’ont ni le même coût ni le même responsable.
⚠️ Quand la somme des contributions ne ferme pas à 100 %, la différence est portée par les interactions : la formule n’est pas une simple somme, et un cumul quadratique classique sous-estimerait la dispersion de Y.
Triangle de conformité. Un point par lot, placé selon la moyenne et l’écart-type de ce lot, vert s’il est capable, rouge sinon. Les courbes de niveau sont les iso-Cpk : la courbe correspondant au Cpk cible délimite la région admissible. La forme triangulaire n’est pas un choix graphique, c’est le modèle lui-même : plus un lot est décentré, moins il a droit à de dispersion. Chaque point est cliquable et bascule la colonne de résultats sur ce lot.
Lot sélectionné. L’histogramme du seul lot retenu, les pièces hors tolérance en rouge, la loi normale ajustée et la moyenne du lot en pointillé. C’est la vue de constat : voilà ce qu’aurait reçu le client si ce lot était parti.
Les résultats : toute la simulation, ou un lot
La colonne de droite possède un bouton à deux positions, et c’est une distinction de fond.
Toute la simulation donne le comportement de la population produite : moyenne, écart-type, étendue observée, asymétrie et aplatissement, taux de non-conformité en ppm, Pp et Ppk. Le bloc Risque lot complète par ce que la moyenne masque : le Cpk médian des lots, le Cpk du cinquième percentile, le nombre de lots sous la cible, et la phrase qui en découle — « un lot pris au hasard a tant de risque d’être non capable ».
Un lot donne le détail d’un lot particulier : son Cpk, sa moyenne, son écart-type, son taux de non-conformité, et surtout le réglage qui a été tiré pour lui, facteur par facteur. C’est la réponse à la question que l’on se pose devant un lot aberrant : pourquoi celui-là ? Une phrase désigne le facteur le plus en cause.
Trois façons de choisir le lot, toutes synchronisées : cliquer un point du triangle de conformité, le prendre dans la liste déroulante (chaque entrée affiche son Cpk), ou utiliser le bouton Lot le plus critique qui saute directement au pire.
⚠️ Le taux de non-conformité est une estimation, et son incertitude est affichée avec lui : « 710 ppm ± 23 % à 95 % avec 100 000 pièces ». Un taux faible demande beaucoup de pièces pour être connu précisément (le nombre nécessaire pour atteindre ±5 % est indiqué). Et si aucune pièce n’est sortie de la tolérance, cela ne veut pas dire que le taux est nul : la borne haute est rappelée.
💡 Quand la distribution de Y s’écarte nettement de la normale — ce qui arrive dès que la formule est fortement non linéaire (les indices Pp et Ppk calculés sur l’écart-type deviennent trompeurs). Ellistat bascule alors sur les indices calculés par percentiles, conformément à l’ISO 22514-2, et le signale. C’est ce qui évite l’incohérence classique entre un Ppk annonçant quelques milliers de ppm et un comptage qui n’en trouve aucun.
Le bilan de variance
Le bandeau du bas est l’équivalent du bilan de tolérance du Spécigraphe, transposé aux variances : un segment par facteur, plus un segment pour les interactions et un pour le bruit. Une pastille indique la part de la variance totale imputable à la dérive inter-lots, toutes causes confondues.
En dessous, les messages tirent les conclusions : le facteur dominant et l’origine de sa contribution, les facteurs sans effet mesurable dont la tolérance peut être relâchée — donc l’argent que l’on peut récupérer sans risque —, et le poids des interactions lorsqu’il devient significatif.
La bibliothèque d’exemples
Le sélecteur en barre de titre charge un cas complet — facteurs, formule, tolérances, plan de simulation — et lance le calcul. C’est la façon la plus rapide de prendre l’écran en main, et la base sur laquelle construire vos propres modèles :
- Ressort de compression : la raideur en fonction du diamètre de fil, du diamètre d’enroulement, du nombre de spires et du module de cisaillement. Le cas typique où un facteur écrase les autres, parce qu’il intervient à la puissance quatre ;
- Chaîne de cotes : un jeu d’assemblage obtenu par différence de trois cotes. Le cas strictement additif, celui du tolérancement classique ;
- Cas de contrôle linéaire : un modèle dont on connaît la réponse exacte, utile pour vérifier la mécanique ;
- Formulaire vide : pour partir de votre propre équation.
💡 Vos propres modèles se conservent : la bibliothèque est destinée à devenir le catalogue des fonctions de transfert de votre entreprise : un ressort, un emmanchement, un jeu de guidage n’ont besoin d’être écrits qu’une fois.
Enregistrement du cas
L’enregistrement d’un cas a lieu soit lors du lancement d’une simulation soit en cliquant sur l’icône d’enregistrement situer à coté du nom. L’icône n’est active que s’il y a des modifications non enregistrées.