


Le principe
Vous mesurez en production une caractéristique Y et une ou deux caractéristiques X. Le nuage de points montre qu’elles sont liées, sans que vous connaissiez d’équation. Le Spécigraphe ajuste un modèle de régression sur ce nuage, puis raisonne à l’envers : puisque Y doit rester entre son Min et son Max, jusqu’où X peut-il varier ?
Le raisonnement se fait en trois temps, et c’est le deuxième qui fait toute la différence :
- le modèle donne la relation moyenne entre X et Y => sa pente est la sensibilité ∂Y/∂X ;
- le modèle n’explique jamais tout : il reste une dispersion résiduelle S. Cette dispersion est prélevée sur la tolérance de Y sous forme d’une bande de garde, avant tout partage. C’est le prix de votre ignorance, et il se paie d’abord ;
- ce qui reste de la tolérance de Y est divisé par la sensibilité : c’est la tolérance de X.
💡 La conséquence est contre-intuitive et vaut d’être retenue : améliorer le modèle libère de la tolérance. Ajouter un second facteur explicatif, qui fait tomber la dispersion résiduelle, élargit directement la tolérance que vous pouvez accorder à vos X , sans rien changer au procédé.
Sélectionner les variables
Les données proviennent de la grille, que l’on ouvre par l’icône grille en haut à droite de la barre de titre. Le panneau Sélection des variables est celui des tests d’hypothèses : une ligne par colonne du jeu de données, un badge de type, et deux colonnes de cases X et Y.
Cocher une ou deux colonnes en X, et une seule en Y. Seules les colonnes numériques sont sélectionnables. Le nombre de X retenus pilote tout le reste de l’écran, sans autre réglage : un facteur donne le parallélogramme classique, deux facteurs donnent une carte d’acceptation dans le plan. Au-delà de deux facteurs, la sélection est refusée.
Déclarer son intention
La colonne Intention est le cœur de l’écran : vous n’y réglez pas un calcul, vous y déclarez ce que vous cherchez et ce que vous acceptez de risquer.
Le sens du transfert
- Y → X (déduire) : la spécification de Y est imposée par le client, par le plan, par la fonction et l’on en déduit celle des X. C’est le sens naturel de la conception.
- X → Y (vérifier) : les tolérances des X sont ce que sait faire le procédé, et l’on regarde ce que devient Y. C’est le sens de la négociation avec un fournisseur, ou de la justification d’un existant.
En basculant de Y → X vers X → Y, les cibles et tolérances des X sont pré-remplies avec le résultat qui vient d’être déduit : on vérifie ainsi immédiatement la cohérence des deux lectures.
Le modèle
Degré 1 ou 2, et en deux facteurs une case Interaction X₁·X₂. Le degré 1 suffit dans la majorité des cas ; le degré 2 sert quand le nuage est visiblement courbe. La régression est calculée par moindres carrés sur variables centrées.
⚠️ Le degré 2 n’est pas gratuit. Il consomme un degré de liberté, rend la tolérance de X asymétrique (le résultat s’affiche alors en +a / −b et non en ±) et peut produire plusieurs zones d’acceptation disjointes. Ne l’utilisez que si la courbure est réelle : l’écran vous le dit dans les deux sens, en suggérant le degré 2 quand les résidus sont courbés, et en signalant le sur-ajustement quand le terme carré n’est pas significatif.
La méthode de cumul
Quatre méthodes, de la plus prudente à la plus économe. Elles ne changent pas le modèle, seulement la façon de prélever la bande de garde et de composer les dispersions.
| Méthode | Ce que vous déclarez | Ce qu’elle suppose |
| Pire des cas (Z·S) | Un coefficient Z (2 par défaut) | La bande de garde vaut Z fois la dispersion résiduelle. Méthode arithmétique, simple, mais très sensible au Z choisi : entre Z = 2 et Z = 3, la tolérance de X peut être divisée par dix. |
| Bande de tolérance (p, 1−α) | Une proportion de pièces conformes (90 / 95 / 99 / 99,73 %) et un niveau de confiance (90 / 95 / 99 %) | Vous ne choisissez plus un coefficient, vous déclarez une intention. Le facteur de couverture est calculé, en tenant compte du nombre de degrés de liberté et de l’incertitude sur la position de la courbe. C’est la méthode à préférer quand le résultat doit être défendable. |
| Statistique | Un Cpk visé sur Y (1 par défaut) | Les dispersions ne s’additionnent plus, elles se composent en quadrature. Nettement moins pénalisant que le pire des cas, à condition que les X soient indépendants. |
| Inertiel | Rien d’autre que la spécification | Le résultat est exprimé en inertie maximale admissible sur X : vous êtes libre d’arbitrer entre dispersion et décentrage, tant que √(σ² + δ²) reste sous l’inertie. Disponible en spécification bilatérale uniquement. |
L’incertitude de mesure sur Y
Elle s’ajoute quadratiquement à la dispersion résiduelle du modèle. Laisser 0 si l’incertitude est négligeable devant le résidu ; la renseigner dès qu’elle est du même ordre, sous peine de transférer sur X une exigence qui n’appartient en réalité qu’au moyen de mesure.
La spécification de Y
On saisit un Min et un Max, et non une cible avec une tolérance. C’est volontaire : les deux champs sont indépendants et l’un des deux peut rester vide.
- Les deux bornes renseignées : spécification bilatérale. Le champ Cible affiche le milieu calculé (auto) ; il devient saisissable si vous voulez décentrer volontairement la cible.
- Une seule borne renseignée : spécification unilatérale. La borne manquante vaut l’infini, le résultat s’exprime sous la forme X ≥ … ou X ≤ …, et aucun intervalle de tolérance n’est fabriqué. La cible devient alors obligatoire : sans elle, on ne sait pas où viser.
- Les deux champs vides : le calcul est bloqué avec un message explicite.
La répartition entre les deux X
Cette liste n’apparaît qu’en deux facteurs et dans le sens Y → X. Elle répond à une difficulté réelle : le problème est sous-déterminé. Une seule équation, deux inconnues — il existe une infinité de couples de tolérances qui garantissent Y. Aucun calcul ne peut trancher seul ; c’est une décision, et l’écran vous demande de la prendre explicitement.
- Au prorata de la capabilité (défaut) : les tolérances sont proportionnelles aux dispersions réellement observées sur les deux X. Les deux procédés se voient donc exiger le même Cp — c’est la répartition la plus équitable industriellement.
- Contribution égale : chaque X contribue pour moitié au budget de Y. Équitable sur le papier, souvent inéquitable dans l’atelier : le facteur le plus capable se voit exiger un effort qu’il n’avait pas besoin de faire.
- X₁ imposé / X₂ imposé : vous fixez la tolérance de l’un — celle que le fournisseur ou la machine sait tenir — et l’autre absorbe ce qui reste. Un message signale le cas où le budget est déjà épuisé.
Les cibles et tolérances des X se saisissent dans le sens X → Y, et en deux facteurs lorsqu’une règle « imposé » est choisie.
Lire le graphique
En un facteur, le graphique porte tout le raisonnement : le nuage des mesures, la courbe du modèle, la bande de garde en aplat bordé de pointillés, les lignes de spécification Min et Max de Y, les bornes déduites sur X en traits verticaux étiquetés, et la zone d’acceptation en aplat vert — l’ensemble des réglages de X qui garantissent Y.
Le survol d’un point donne ses valeurs, la valeur prédite et le résidu. Le survol du fond donne la valeur de X, le Y prédit, la sensibilité locale et la probabilité de conformité à cet endroit.
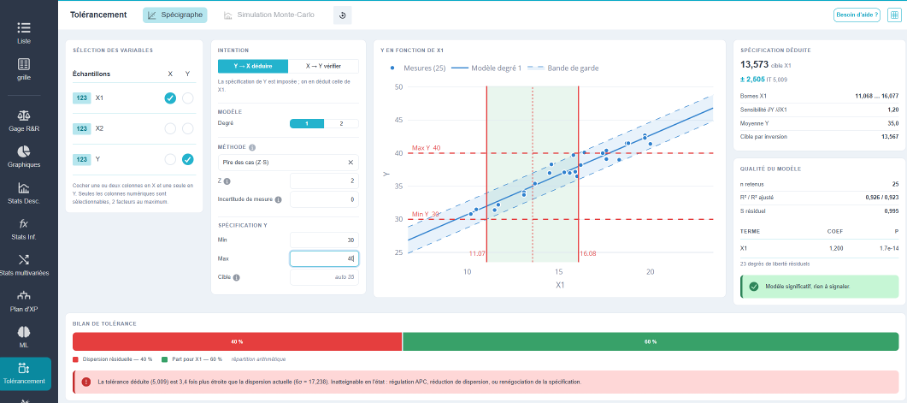
Sur la copie d’écran ci-dessus, la spécification de Y est 30 / 40 et le modèle de degré 1 a une pente de 1,20 : la tolérance de 10 sur Y, une fois retirée la bande de garde, autorise un intervalle de 5,009 sur X₁, entre 11,068 et 16,077.
En deux facteurs, la zone d’acceptation n’est plus un intervalle mais une région du plan (X₁, X₂). Deux vues sont proposées par le bouton segmenté :
- Carte 2D, vue de travail et vue par défaut. On y lit la région d’acceptation en aplat, la ligne iso-Y = cible, l’ellipse de dispersion actuelle du procédé à 95 %, le nuage des mesures et le rectangle de tolérance déduit. C’est la vue qui sert à décider : le rectangle est ce qui part sur un plan, la région est la vérité, l’ellipse dit où le procédé vit réellement.
- 3D, vue de compréhension. La surface de réponse est tracée en maillage, colorée par la conformité, avec les plans de spécification et deux curseurs de rotation et d’élévation. Elle sert à expliquer la forme de la relation, pas à décider.
💡 Le rectangle est toujours plus petit que la région d’acceptation : un plan porte des tolérances rectangulaires, alors que la zone réellement conforme est oblique dès que les deux facteurs se compensent. L’écart entre les deux est exactement la tolérance que la forme rectangulaire vous fait perdre — et c’est ce que l’on récupère en pilotant les deux facteurs conjointement.
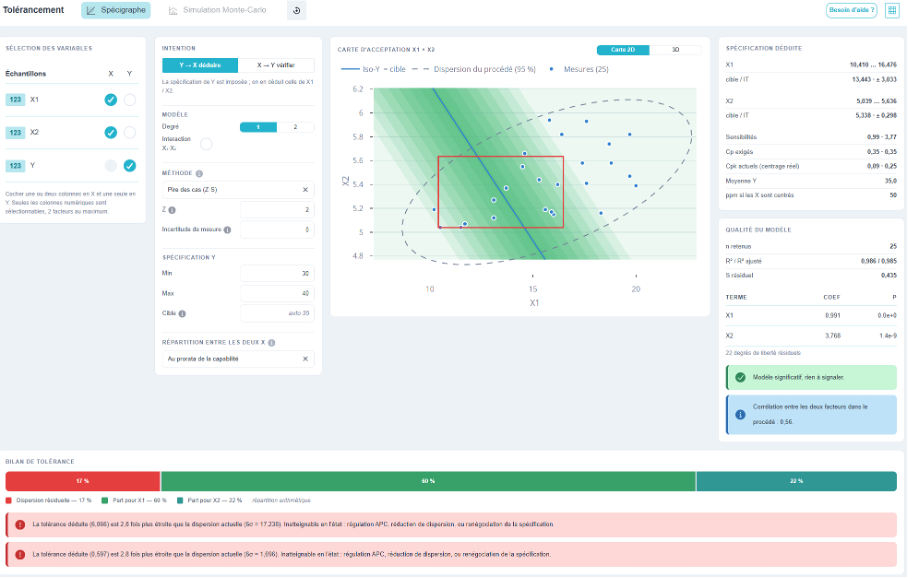
Sur cette copie d’écran, la répartition au prorata de la capabilité accorde ±3,033 à X₁ et ±0,298 à X₂ : les deux tolérances sont très différentes, mais elles exigent le même Cp (0,35) de chacun des deux procédés.
La spécification déduite
La colonne de droite donne le résultat sous la forme directement portable sur un plan : la cible de chaque X, l’intervalle de tolérance, et les deux bornes. S’y ajoutent les grandeurs qui permettent de juger ce résultat :
- la sensibilité ∂Y/∂X, qui dit de combien Y bouge quand X bouge d’une unité. C’est le taux de change du transfert : une sensibilité forte rend la tolérance de X étroite ;
- la moyenne de Y attendue au réglage proposé ;
- la cible par inversion, affichée à côté de la cible retenue quand les deux diffèrent. Au degré 1 elles coïncident ; dès que la courbe n’est pas droite, la cible retenue est le point de marge maximale, c’est-à-dire le réglage le plus robuste, et non l’inverse mathématique de la cible de Y ;
- en deux facteurs, les Cp exigés (ce qu’il faudrait tenir) en face des Cpk actuels (ce que le procédé tient réellement, décentrage compris), et le ppm prévisionnel si les X sont centrés.
⚠️ Au degré 2, la tolérance est asymétrique et s’affiche en +a / −b. Ne la reportez pas en ± sur le plan : la marge n’est pas la même des deux côtés de la cible.
La qualité du modèle
Un transfert de tolérance ne vaut que ce que vaut le modèle. Le bloc Qualité du modèle donne, dans l’ordre de lecture utile : le nombre de points retenus, le R² et le R² ajusté, la dispersion résiduelle S, puis un tableau des termes du modèle avec leur coefficient et leur p-value, et le nombre de degrés de liberté résiduels. Un bandeau coloré conclut, avec le même code couleur que les tests d’hypothèses.
💡 Le R² n’est pas le bon indicateur ici, c’est S qui compte. Le R² dit quelle part de la variation est expliquée ; S dit en unités de Y ce que le modèle ne sait pas prédire — et c’est ce S, et lui seul, qui est prélevé sur votre tolérance.
Le bilan de tolérance
C’est le bandeau en pleine largeur, en bas de l’écran, et probablement l’information la plus utile de l’écran. Il décompose la tolérance de Y en segments : la dispersion résiduelle du modèle, l’incertitude de mesure, puis la part qui reste pour X₁ et pour X₂.
La mention sous la barre précise la nature du partage : répartition arithmétique en pire des cas et en bande de tolérance, répartition des variances en statistique et en inertiel. Les deux ne se lisent pas de la même façon et ne s’additionnent pas de la même façon.
💡 Lire le bilan avant le résultat. Quand la dispersion résiduelle occupe 40 % de la barre, cela signifie que 40 % de la tolérance du client est déjà consommée par ce que vous ne savez pas expliquer, avant même d’avoir fabriqué une pièce. Le seul levier est alors le modèle : un facteur explicatif de plus, ou une mesure moins bruitée.
Les garde-fous
Un transfert de tolérance produit toujours un nombre. La question est de savoir si ce nombre veut dire quelque chose. Ellistat vérifie pour vous les situations dans lesquelles il ne veut rien dire, et les affiche en clair sous le graphique ou dans le bandeau de bilan.
| Situation détectée | Ce que dit Ellistat |
| Pente non significative | La liaison est trop faible pour porter un tolérancement : l’intervalle sur X n’est pas borné. Le résultat est bloqué, aucun chiffre n’est affiché — c’est volontaire. |
| Pente significative mais incertaine | L’incertitude sur la pente élargit la tolérance vraie ; l’ordre de grandeur de cet élargissement est indiqué. |
| Courbure non modélisée | Les résidus du degré 1 dessinent une courbure : passer au degré 2 est suggéré. |
| Courbure non significative | Au degré 2, le terme carré n’est pas significatif : le modèle est sur-ajusté, revenir au degré 1. |
| Dispersion non homogène | La dispersion s’élargit d’un bout à l’autre du nuage : la bande n’est plus un parallélogramme, la tolérance déduite est asymétrique. |
| Facteurs corrélés | Les deux X varient ensemble dans le procédé : leurs coefficients sont mal séparés, la répartition entre les deux est fragile. |
| Extrapolation | La cible déduite sort de la plage réellement observée : le modèle n’y a jamais été vérifié. |
| Faisabilité industrielle | La tolérance déduite est comparée à la dispersion réellement observée sur X. Si elle est plus étroite, le message le dit en clair et chiffre le rapport. |
| Résidu dominant | Le modèle consomme plus de la moitié de la tolérance de Y : chercher un facteur explicatif supplémentaire avant de tolérancer. |
| Aucune zone d’acceptation | Aucune valeur de X ne permet de garantir la spécification de Y : le transfert est impossible en l’état, et l’écran indique ce qu’il faudrait relâcher. |
💡 Ces messages ne sont pas des options : ils s’affichent d’eux-mêmes. C’est ce qui distingue un transfert de tolérance d’une simple division par la pente.
Le sens X → Y : vérifier
L’autre sens de lecture répond à une question de négociation : « mon procédé sait tenir telle tolérance sur X ; qu’est-ce que cela donne sur Y ? ». Vous saisissez les cibles et les tolérances des X, et Ellistat rend le comportement de Y : moyenne et écart-type attendus, intervalle de tolérance induit face à celui dont vous disposez, Cp et Cpk prévisionnels, et le taux de non-conformité en ppm.
Le calcul du ppm passe par une simulation, et non par une simple mise en cascade des tolérances : dès que le modèle n’est pas une droite, la propagation linéaire des écarts est fausse.
💡 Le va-et-vient entre les deux sens est le geste le plus productif de l’écran. On déduit d’abord la tolérance nécessaire (Y → X), on constate qu’elle est inatteignable, on bascule en X → Y avec ce que le procédé sait faire, et l’on obtient le ppm à annoncer au client — ou l’argument chiffré pour renégocier la spécification. Au basculement, les valeurs déduites sont reprises automatiquement.