


El principio
En producción, mides una característica Y y una o dos características X. La nube de puntos muestra que están relacionadas, sin que conozcas ninguna ecuación. El Spécigraphe ajusta un modelo de regresión a esta nube de puntos y, a continuación, razona a la inversa: dado que Y debe mantenerse entre su valor mínimo y su valor máximo, ¿hasta qué punto puede variar X?
El razonamiento se desarrolla en tres pasos, y es el segundo el que marca la diferencia:
- El modelo expresa la relación media entre X e Y => su pendiente es la sensibilidad ∂Y/∂X;
- El modelo nunca lo explica todo: siempre queda una dispersión residual S. Esta dispersión se deduce de la tolerancia de Y en forma de un margen de seguridad, antes de cualquier reparto. Ese es el precio de tu ignorancia, y hay que pagarlo primero;
- lo que queda de la tolerancia de Y se divide entre la sensibilidad: ese es el valor de la tolerancia de X.
💡 La consecuencia es contraintuitiva y merece la pena tenerla en cuenta: mejorar el modelo libera tolerancia. Añadir un segundo factor explicativo, que reduce la dispersión residual, amplía directamente la tolerancia que puedes conceder a tus X, sin cambiar nada en el proceso.
Seleccionar las variables
Los datos proceden de la tabla, a la que se accede mediante el icono de la tabla situado en la esquina superior derecha de la barra de título. El panel «Selección de variables» es el de las pruebas de hipótesis: una línea por cada columna del conjunto de datos, un indicador de tipo y dos columnas con casillas X e Y.
Marca una o dos columnas en X y solo una en Y. Solo se pueden seleccionar las columnas numéricas. El número de X seleccionadas determina el resto de la pantalla, sin necesidad de ningún otro ajuste: un factor da lugar al paralelogramo clásico; dos factores dan lugar a un mapa de aceptación en el plano. A partir de dos factores, la selección se rechaza.
Manifestar su intención
La columna «Intención» es el núcleo de la pantalla: en ella no se establece un cálculo, sino que se indica lo que se busca y lo que se está dispuesto a arriesgar.
El significado de la transferencia
- Y → X (deducir): la especificación de Y viene determinada por el cliente, por el plano y por la función, y a partir de ahí se deduce la de X. Ese es el sentido natural del diseño.
- X → Y (comprobar): las tolerancias de X son lo que permite el proceso, y se observa en qué se convierte Y. Ese es el sentido de la negociación con un proveedor o de la justificación de una situación existente.
Al pasar de Y → X a X → Y, los valores objetivo y las tolerancias de las X se rellenan automáticamente con el resultado que se acaba de deducir: de este modo, se comprueba inmediatamente la coherencia entre ambas lecturas.
El modelo
Grado 1 o 2, y con dos factores, una casilla de interacción X₁·X₂. El grado 1 es suficiente en la mayoría de los casos; el grado 2 se utiliza cuando la nube presenta una curvatura evidente. La regresión se calcula mediante el método de los mínimos cuadrados sobre variables centradas.
⚠️ El grado 2 no es gratuito. Consume un grado de libertad, hace que la tolerancia de X sea asimétrica (el resultado se muestra entonces como +a / −b y no como ±) y puede generar varias zonas de aceptación disjuntas. Úsalo solo si la curvatura es real: la pantalla te lo indica en ambos sentidos, sugiriendo el grado 2 cuando los residuos son curvos y señalando el sobreajuste cuando el término cuadrático no es significativo.
El método de acumulación
Cuatro métodos, desde el más prudente hasta el más económico. No modifican el modelo, sino únicamente la forma de extraer la banda de margen y de componer las dispersiones.
| Método | Lo que declaras | Lo que implica |
| El peor de los casos (Z·S) | Un coeficiente Z (2 por defecto) | El margen de seguridad es igual a Z veces la dispersión residual. Se trata de un método aritmético, sencillo, pero muy sensible al valor de Z elegido: entre Z = 2 y Z = 3, la tolerancia de X puede reducirse a una décima parte. |
| Banda de tolerancia (p, 1−α) | Una proporción de piezas conformes (90 / 95 / 99 / 99,73 %) y un nivel de confianza (90 / 95 / 99 %) | Ya no se elige un coeficiente, sino que se declara una intención. El factor de cobertura se calcula teniendo en cuenta el número de grados de libertad y la incertidumbre sobre la posición de la curva. Es el método más recomendable cuando el resultado debe ser defendible. |
| Estadística | Un Cpk objetivo en Y (1 por defecto) | Las dispersiones ya no se suman, sino que se componen en cuadratura. Es claramente menos desfavorable que el peor de los casos, siempre que las variables X sean independientes. |
| Inercial | Nada más que la especificación | El resultado se expresa en términos de inercia máxima admisible en X: puedes elegir libremente entre dispersión y descentramiento, siempre que √(σ² + δ²) se mantenga por debajo de la inercia. Disponible únicamente en especificación bilateral. |
La incertidumbre de medición en Y
Se suma cuadráticamente a la dispersión residual del modelo. Deja el valor en 0 si la incertidumbre es insignificante en comparación con el residuo; indícala siempre que sea del mismo orden, ya que, de lo contrario, se transferiría a X un requisito que, en realidad, solo corresponde al medio de medición.
La especificación de Y
Se introducen un valor mínimo y uno máximo, y no un valor objetivo con una tolerancia. Esto es intencionado: ambos campos son independientes y uno de ellos puede dejarse en blanco.
- Los dos puntos indicados: especificación bilateral. El campo «Objetivo» muestra el punto medio calculado (automático); se puede modificar si deseas desplazar el objetivo de forma intencionada.
- Solo se indica un límite: especificación unilateral. El límite que falta se considera infinito, el resultado se expresa en la forma X ≥ … o X ≤ …, y no se establece ningún intervalo de tolerancia. El objetivo pasa entonces a ser obligatorio: sin él, no se sabe hacia dónde apuntar.
- Si ambos campos están vacíos: el cálculo se bloquea y aparece un mensaje explícito.
La distribución entre las dos X
Esta lista solo aparece en dos factores y en la dirección Y → X. Responde a una dificultad real: el problema está subdeterminado. Una sola ecuación, dos incógnitas: existe una infinidad de pares de tolerancias que garantizan el valor de Y. Ningún cálculo puede resolverlo por sí solo; se trata de una decisión, y la pantalla le pide que la tome de forma explícita.
- En proporción a la capacidad (por defecto): las tolerancias son proporcionales a las dispersiones observadas realmente en las dos variables X. Por lo tanto, a ambos procesos se les exige el mismo Cp; esta es la distribución más equitativa desde el punto de vista industrial.
- Contribución equitativa: cada X aporta la mitad del presupuesto de Y. Aunque parezca justo sobre el papel, a menudo resulta injusto en el taller: al trabajador más capaz se le exige un esfuerzo que no tenía por qué realizar.
- X₁ fijado / X₂ fijado: tú estableces la tolerancia de uno —la que el proveedor o la máquina puede cumplir— y el otro absorbe lo que queda. Un mensaje avisa cuando ya se ha agotado el presupuesto.
Los objetivos y las tolerancias de los ejes X se introducen en la dirección X → Y, y en dos factores cuando se selecciona una regla «impuesta».
Ver el gráfico
En un solo gráfico se resume todo el razonamiento: la nube de medidas, la curva del modelo, la banda de seguridad en color liso bordeada por una línea punteada, las líneas de especificación mínima y máxima de Y, los límites deducidos en X mediante líneas verticales etiquetadas, y la zona de aceptación en color verde liso —el conjunto de ajustes de X que garantizan el valor de Y—.
Al pasar el cursor por encima de un punto, se muestran sus valores, el valor previsto y el residuo. Al pasar el cursor por encima del fondo, se muestran el valor de X, el valor previsto de Y, la sensibilidad local y la probabilidad de conformidad en ese punto.
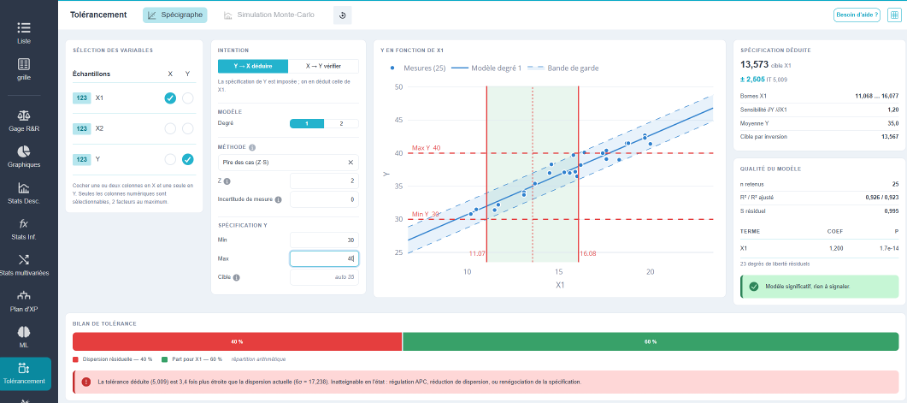
En la captura de pantalla anterior, la especificación de Y es 30/40 y el modelo de grado 1 tiene una pendiente de 1,20: la tolerancia de 10 en Y, una vez eliminada la banda de seguridad, permite un intervalo de 5,009 en X₁, entre 11,068 y 16,077.
En dos factores, la zona de aceptación ya no es un intervalo, sino una región del plano (X₁, X₂). El botón segmentado ofrece dos vistas:
- Mapa 2D, vista de trabajo y vista predeterminada. En él se pueden observar la región de aceptación en plano, la línea iso-Y = objetivo, la elipse de dispersión actual del proceso al 95 % %, la nube de medidas y el rectángulo de tolerancia deducido. Esta es la vista que sirve para tomar decisiones: el rectángulo es lo que se proyecta en un plano, la región es la realidad y la elipse indica dónde se sitúa realmente el proceso.
- 3D, vista de comprensión. La superficie de respuesta se representa en forma de malla, coloreada según el grado de conformidad, con los planos de especificación y dos controles deslizantes de rotación y elevación. Sirve para explicar la forma de la relación, no para tomar decisiones.
💡 El rectángulo siempre es más pequeño que la zona de aceptación: un plano presenta tolerancias rectangulares, mientras que la zona que realmente cumple los requisitos es oblicua en cuanto ambos factores se compensan. La diferencia entre ambos es exactamente la tolerancia que se pierde debido a la forma rectangular, y eso es lo que se recupera al controlar ambos factores de forma conjunta.
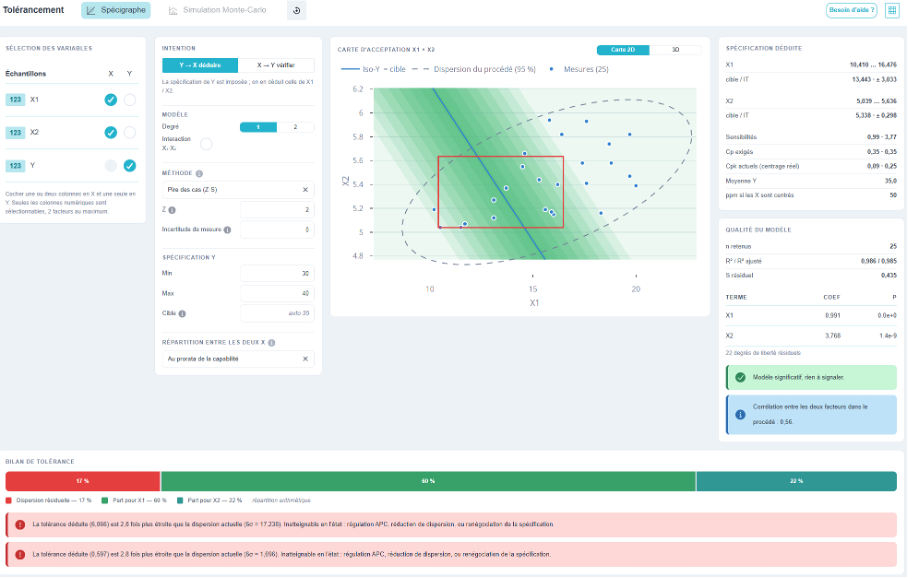
En esta captura de pantalla, la distribución prorrateada de la capacidad asigna ±3,033 a X₁ y ±0,298 a X₂: ambas tolerancias son muy diferentes, pero exigen el mismo Cp (0,35) para cada uno de los dos procesos.
La especificación deducida
La columna de la derecha muestra el resultado en un formato que se puede trasladar directamente a un plano: el objetivo de cada X, el intervalo de tolerancia y los dos límites. A ello se suman las magnitudes que permiten evaluar dicho resultado:
- la sensibilidad ∂Y/∂X, que indica cuánto varía Y cuando X varía en una unidad. Es la tasa de transferencia: una sensibilidad elevada reduce la tolerancia de X;
- la media esperada de Y con el ajuste propuesto;
- el objetivo por inversión, que aparece junto al objetivo seleccionado cuando ambos difieren. En el grado 1 coinciden; en cuanto la curva no es recta, el objetivo seleccionado es el punto de margen máximo, es decir, el ajuste más robusto, y no el inverso matemático del objetivo de Y;
- en dos factores: los Cp exigidos (lo que debería cumplirse) frente a los Cpk actuales (lo que el proceso cumple realmente, incluido el descentramiento), y las ppm previstas si las X estuvieran centradas.
⚠️ En el grado 2, la tolerancia es asimétrica y se indica como +a / −b. No la traslade como ± en el plano: el margen no es el mismo a ambos lados del blanco.
La calidad del modelo
Una transferencia de tolerancia solo tiene el valor que tiene el modelo. El bloque «Calidad» del modelo ofrece, en el orden de lectura habitual: el número de puntos seleccionados, el R² y el R² ajustado, la dispersión residual S, seguido de una tabla con los términos del modelo, sus coeficientes y sus valores p, y el número de grados de libertad residuales. Una barra de color concluye el resultado, con el mismo código de colores que las pruebas de hipótesis.
💡 El R² no es el indicador adecuado en este caso; lo que importa es S. El R² indica qué parte de la variación se explica; S indica, en unidades de Y, lo que el modelo no sabe predecir —y es ese S, y solo ese S, el que se deduce de tu tolerancia.
El informe de tolerancia
Es la barra que ocupa todo el ancho, en la parte inferior de la pantalla, y probablemente la información más útil que aparece en ella. Desglosa la tolerancia de Y en segmentos: la dispersión residual del modelo, la incertidumbre de medición y, a continuación, la parte que queda para X₁ y para X₂.
La indicación que aparece debajo de la barra especifica la naturaleza del reparto: reparto aritmético en el peor de los casos y dentro de un margen de tolerancia, reparto de varianzas en estadística y en inercial. Ambos no se interpretan de la misma manera ni se suman de la misma forma.
💡 Lee el balance antes del resultado. Cuando la dispersión residual ocupa 40 % de la barra, eso significa que 40 % de la tolerancia del cliente ya se han consumido por algo que no sabes explicar, incluso antes de haber fabricado una pieza. La única solución es entonces el modelo: un factor explicativo más o una medida con menos ruido.
Las medidas de seguridad
Una transferencia de tolerancia siempre genera un número. La cuestión es saber si ese número significa algo. Ellistat comprueba por ti las situaciones en las que no significa nada y las muestra claramente debajo del gráfico o en la barra de resumen.
| Situación detectada | Lo que dice Ellistat |
| Pendiente no significativa | La conexión es demasiado débil para admitir una tolerancia: el intervalo en X no está acotado. El resultado queda bloqueado y no se muestra ningún número; esto es intencionado. |
| Una tendencia significativa, pero incierta | La incertidumbre sobre la pendiente amplía la tolerancia real; se indica el orden de magnitud de dicha ampliación. |
| Curvatura no modelizada | Los residuos del grado 1 forman una curva: se recomienda pasar al grado 2. |
| Curvatura no significativa | En el grado 2, el término cuadrático no es significativo: el modelo está sobreajustado; hay que volver al grado 1. |
| Dispersión no homogénea | La dispersión se amplía de un extremo a otro de la nube: la franja ya no es un paralelogramo, y la tolerancia calculada es asimétrica. |
| Factores correlacionados | Las dos X varían conjuntamente en el proceso: sus coeficientes están poco diferenciados y la distribución entre ambas es inestable. |
| Extrapolación | El valor estimado se sale del rango realmente observado: el modelo nunca se ha comprobado en ese rango. |
| Viabilidad industrial | La tolerancia calculada se compara con la dispersión realmente observada en X. Si es más estrecha, el mensaje lo indica claramente y cifra el informe. |
| Residuo predominante | El modelo consume más de la mitad de la tolerancia de Y: hay que buscar un factor explicativo adicional antes de aplicar la tolerancia. |
| No hay zona de recepción | Ningún valor de X permite garantizar la especificación de Y: la transferencia es imposible en estas condiciones, y la pantalla indica qué habría que soltar. |
💡 Estos mensajes no son opciones: aparecen automáticamente. Eso es lo que distingue una transferencia de tolerancia de una simple división por la pendiente.
La dirección X → Y: comprobar
La otra forma de interpretarlo responde a una cuestión de negociación: «Mi proceso es capaz de mantener tal tolerancia en X; ¿qué resultados da eso en Y?». Introduzcas los objetivos y las tolerancias de las variables X, y Ellistat te mostrará el comportamiento de la variable Y: media y desviación típica esperadas, intervalo de tolerancia resultante en comparación con el que ya tienes, Cp y Cpk previstos, y la tasa de no conformidad en ppm.
El cálculo de las partes por millón (ppm) se realiza mediante una simulación, y no mediante una simple suma en cascada de las tolerancias: en cuanto el modelo deja de ser una recta, la propagación lineal de las desviaciones resulta errónea.
💡 El vaivén entre ambos sentidos es el gesto más productivo de la pantalla. Primero se deduce la tolerancia necesaria (Y → X), se constata que es inalcanzable, se cambia a X → Y con lo que el proceso es capaz de hacer, y se obtiene el ppm que hay que comunicar al cliente —o el argumento cuantificado para renegociar la especificación—. Al cambiar de sentido, los valores deducidos se retoman automáticamente.